María Ruiz
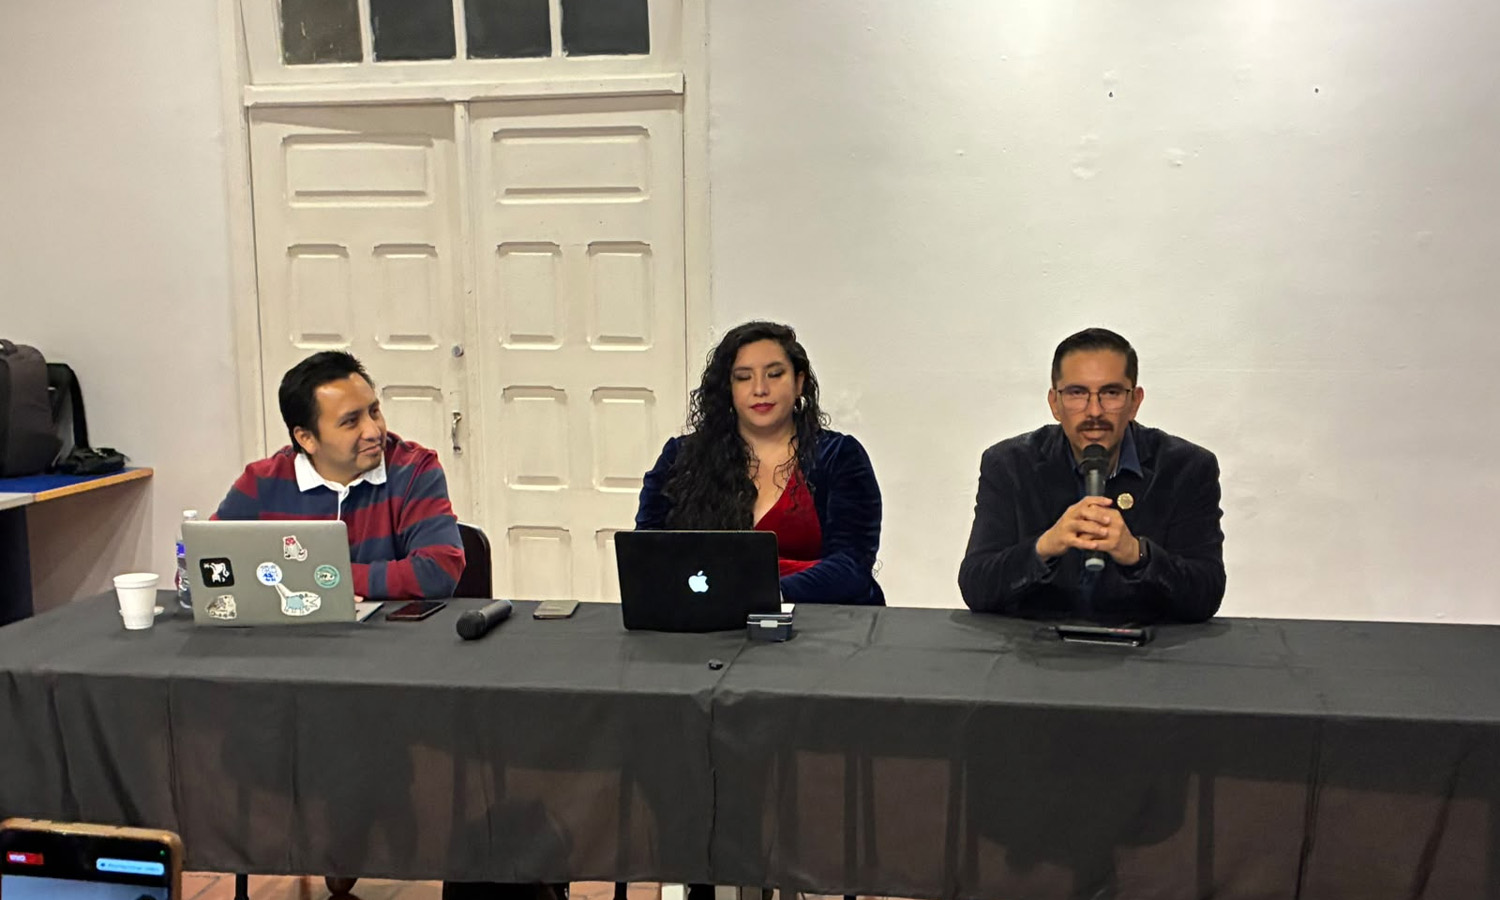
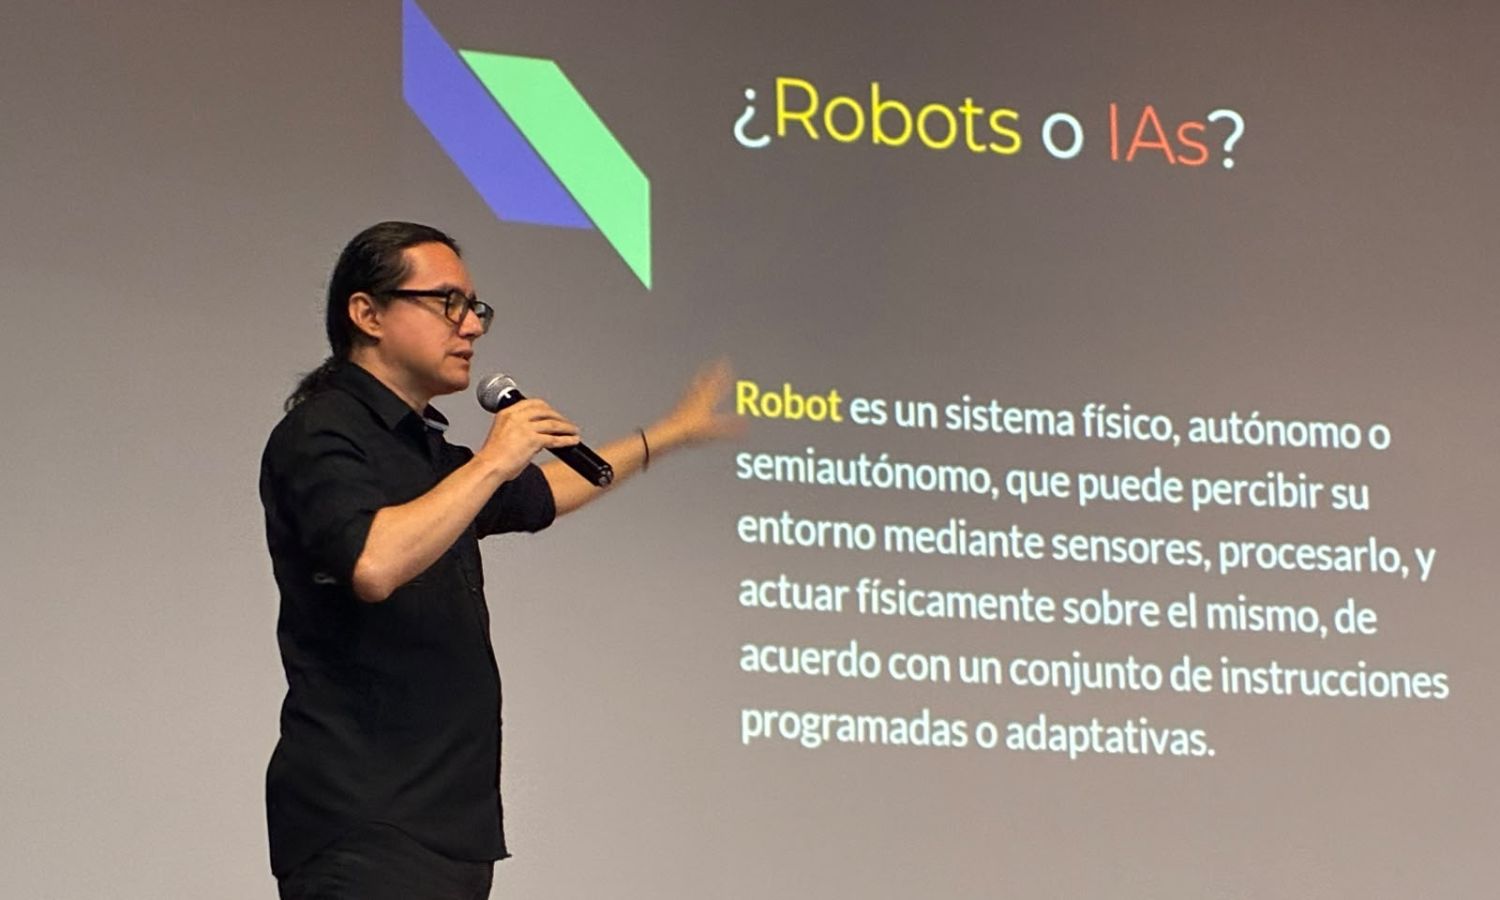
La dificultad para determinar si un texto, una imagen o un video fueron creados con inteligencia artificial plantea nuevos desafíos para el periodismo, particularmente cuando se pretende atribuir el uso de estas herramientas sin contar con pruebas concluyentes, reconoció el especialista Diego Espitia, integrante del Grupo Universitario de Inteligencia Artificial de la Universidad Autónoma de San Luis Potosí (UASLP).
Y aunque la pregunta planteada durante la conferencia buscaba propuestas para prevenir acusaciones de uso indebido de inteligencia artificial contra periodistas, el especialista reconoció que no podía ofrecer una respuesta precisa. Sin embargo, su intervención se centró en la necesidad de desarrollar infraestructura tecnológica, impulsar la investigación y mantener una discusión permanente sobre el uso de estas herramientas.
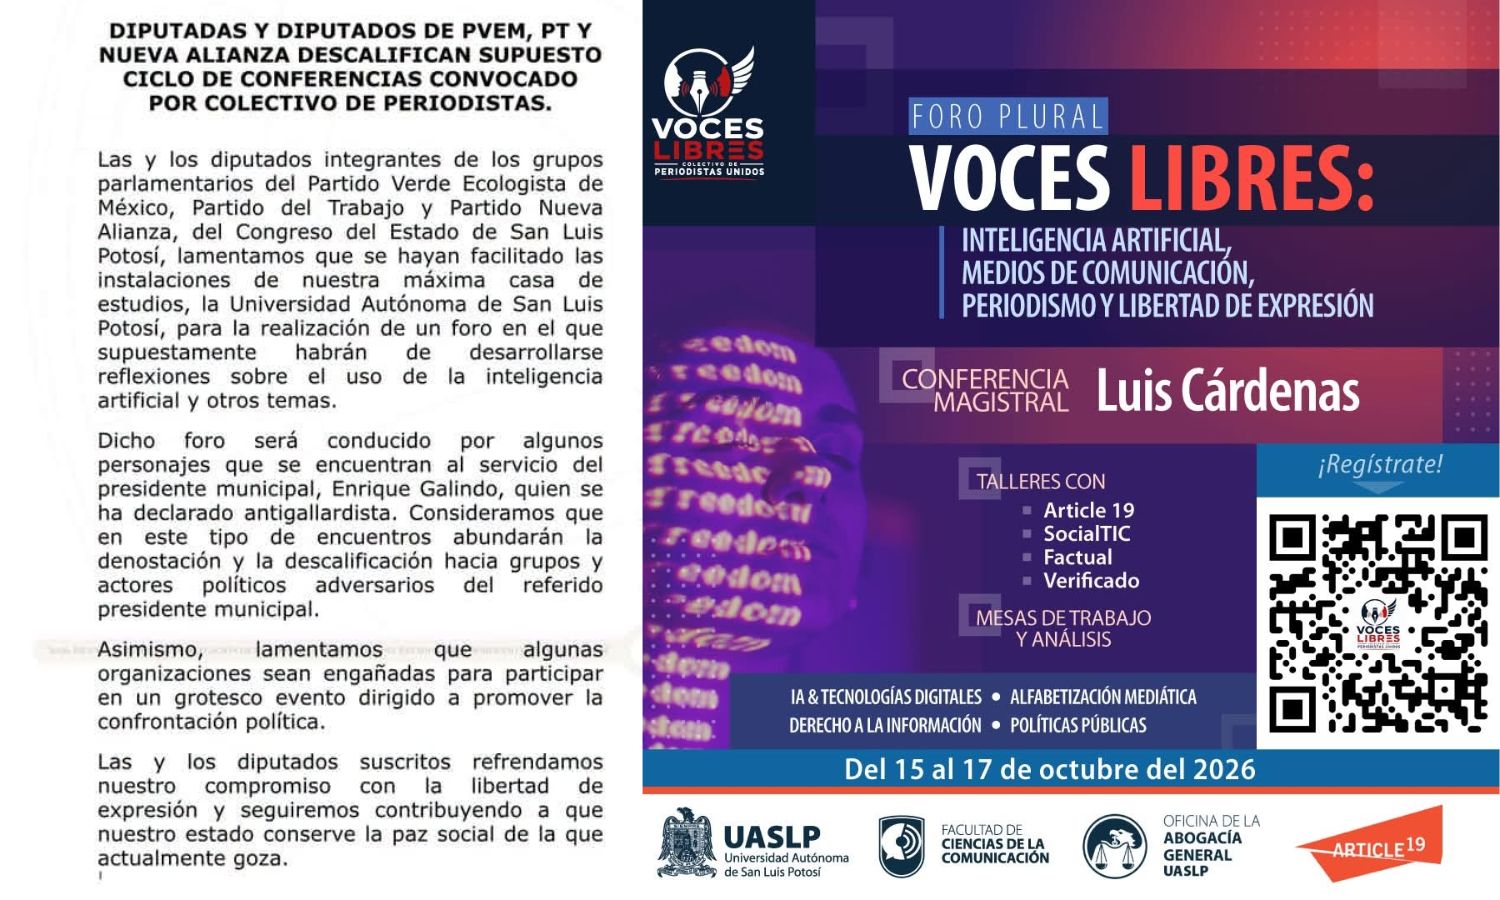
Por ello, durante su conferencia magistral dentro del foro plural Voces Libres, sobre inteligencia artificial generativa y su impacto en el periodismo, detalló qué medidas podrían implementarse para evitar que periodistas sean acusados de utilizar inteligencia artificial en sus reportajes, especialmente ante el riesgo de que una publicación que incomode a un actor político sea señalada como artificial.
Espitia reconoció que actualmente es complicado establecer con certeza el origen de los contenidos mediante herramientas tecnológicas, pues los sistemas de inteligencia artificial han avanzado hasta el punto de dificultar la distinción entre las producciones humanas y las generadas por máquinas.
“Desafortunadamente por las razones que sean Latinoamérica tiene un rezago muy fuerte en este tipo de tecnologías, de inteligencia artificial”, señaló al explicar que desarrollar y entrenar modelos requiere inversiones considerables en infraestructura computacional, además de acceso a componentes tecnológicos que no siempre están disponibles.
Ante este panorama, planteó:
“Creo que el ejercicio que debería uno hacer es poder tener, no sé si de manera nacional, de manera estatal, de manera local, infraestructura computacional con modelos de pesos abiertos”.
El especialista explicó que disponer de modelos abiertos permitiría analizar textos, imágenes y videos para estudiar su comportamiento y buscar indicadores estadísticos que ayuden a identificar posibles contenidos artificiales, aunque no presentó un procedimiento definitivo para determinar su origen.
También consideró:
“Ojalá podamos decir, México desarrolló su propio modelo de inteligencia artificial y se sabe sobre el manejo de la información, y no depender de los modelos ajenos que no tienen esas bases, pero sí mucho sesgo”.
Sobre la discusión en torno a la regulación de estas tecnologías, Espitia sostuvo que la actualización de conocimientos y el intercambio entre especialistas, científicos, legisladores y otras disciplinas deben mantenerse de forma continua, en lugar de limitarse a reaccionar cuando ocurre un caso problemático.
El ponente agregó que comprender cómo funcionan estos sistemas también representa un reto científico, debido a que sus procesos internos no siempre son transparentes y el acceso a los componentes necesarios para estudiarlos depende, en muchos casos, de las empresas que los desarrollan.